电商运营与数据治理
E-Shop 运营专家
一套面向电商运营、采购与业务 Owner 的语义化智能运营工作台,通过数据版本、业务语义、人工审批与 AI 辅助,把多源材料沉淀为可复现的 Full List、分析成果和业务知识资产。
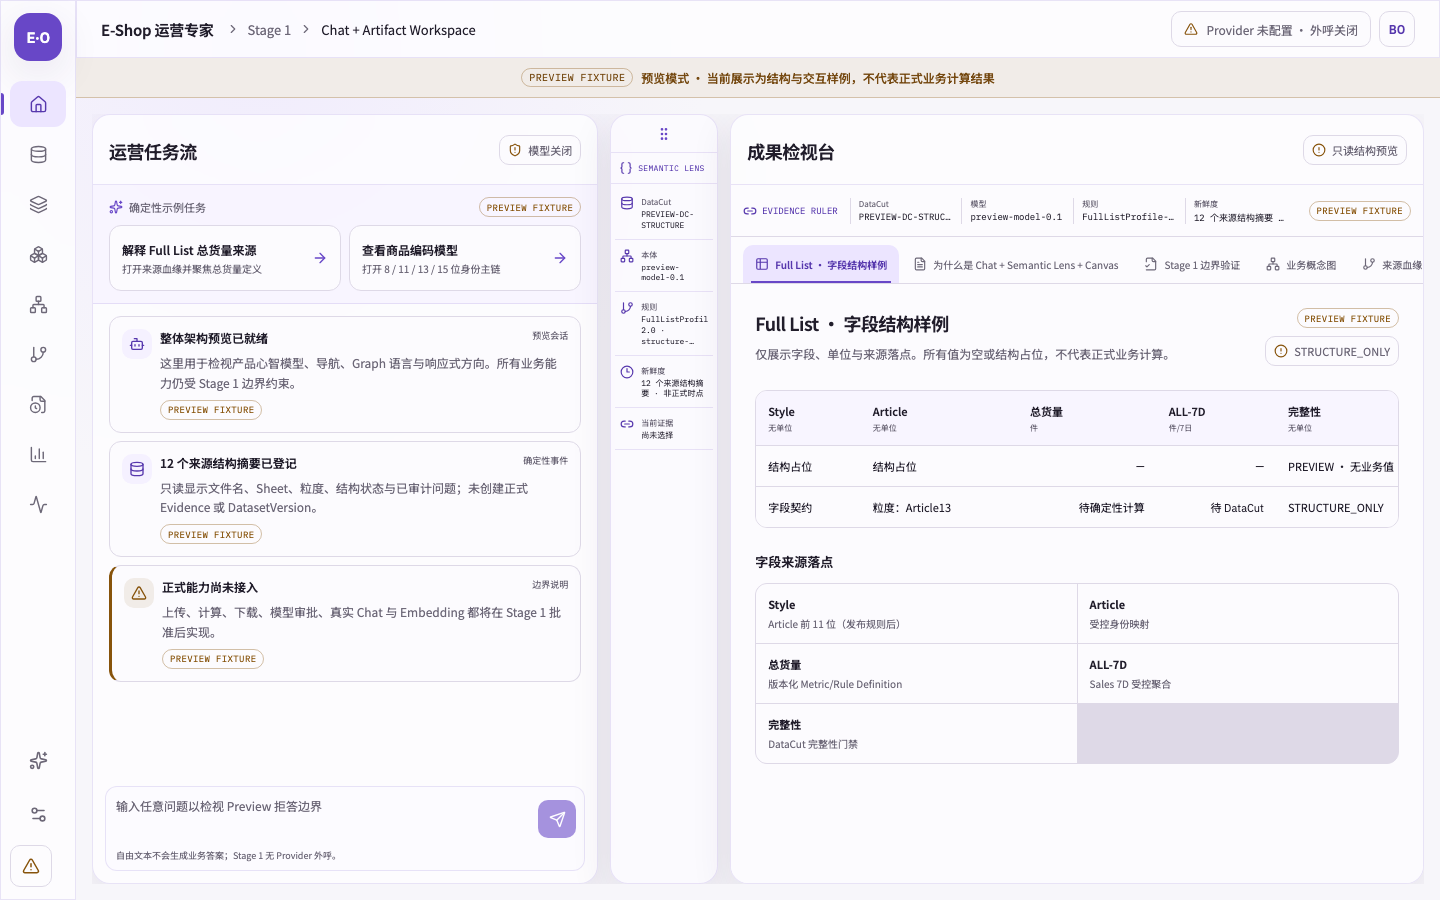
项目要把分散的 Excel、规则文档与业务经验转化为可追溯的运营决策系统,因此没有从“做一个聊天页面”开始,而是先审计现有业务材料:12 个 Excel 工作簿、17 个实际业务 Sheet,以及 DOCX、Markdown 等规则文档。团队逐一确认表头、原生粒度、候选主键、时间字段、异常值、跨表覆盖率与来源权威,再把 Full List、盘货和运营分析规则拆成可以验证的业务对象与指标。
材料审计之后,需求被整理成一套工程级 PRD,并先用可点击 Preview 确认 Chat、Semantic Lens、Artifact Canvas、业务概念图和来源血缘的工作方式。方向稳定后,再按 Evidence、DatasetVersion、DataCut、语义变更、Full List、Chat 与 Graph 的业务闭环逐层建设,避免把多源数据粗暴拼成无法复现的大宽表。
库存、销售、采购、退货、商品主数据和标签分散在不同文件中,更新时间、统计范围和更新方式并不一致。文件夹里“最新”的文件不一定属于同一个业务时点,手工拼接也无法说明一张报表到底用了哪一批输入。
同名的“款号”“库存”或“销售”字段,可能对应 8、11、13、15 位编码、平台商品 ID、不同仓库与渠道,甚至不同的时间窗口和数据粒度。规则又散落在人脑、Word、Markdown 和 Excel 公式里;如果让 AI 直接解释、生成 SQL 或修改口径,结果可能看起来合理,却无法审计、复现或交给下一位同事继续使用。
系统把文件、规则和消息先登记为不可变 Evidence,记录来源、时间、范围、哈希与处理状态;Source Adapter 再分别识别 Sheet、表头、类型、粒度、候选键、时间和质量问题。每个来源形成 DatasetVersion,每次分析冻结为一个 DataCut,从入口就锁定可复现的输入。
商品身份桥接显式区分 Style、Article、SKU 与平台商品 ID,业务语义层统一维护术语、Shape、规则、字段映射和来源血缘。新字段、新关系和新规则先形成 Candidate / Diff,经验证和人工审批后才发布,历史 DataCut 与 Artifact 仍然可以回看。
正式 Full List 由确定性引擎基于冻结 DataCut 计算,并在 Artifact Canvas 中交付固定五 Sheet XLSX、表格、报告、图谱和校验说明。AI 只在有证据的范围内负责检索、解释和提出建议;引用、权限、模型版本和高风险人工确认都保留在同一条审计链上。
AI 技术
DATA_GOVERNED_DECISION_SUPPORT / SEMANTIC_MODELING / FULL_LIST_ENGINE / EVIDENCE_LINEAGE / AI_AGENT_GOVERNANCE
工作流、管道与 Agent
Evidence 与 Source Adapter / DatasetVersion 与 Frozen DataCut / 商品身份桥接与业务语义治理 / 确定性 Full List 与 Artifact Canvas / AI 引用、业务概念图与字段血缘
原始材料先以不可变 Evidence 登记并进行安全检查,正式任务只读取冻结 DataCut;数据、规则、模型、映射和成果保留版本与哈希,AI 没有证据、权限或已批准 Provider 时会降级或拒答。
产品与数据治理证据
从运营工作台,到来源血缘与业务语义
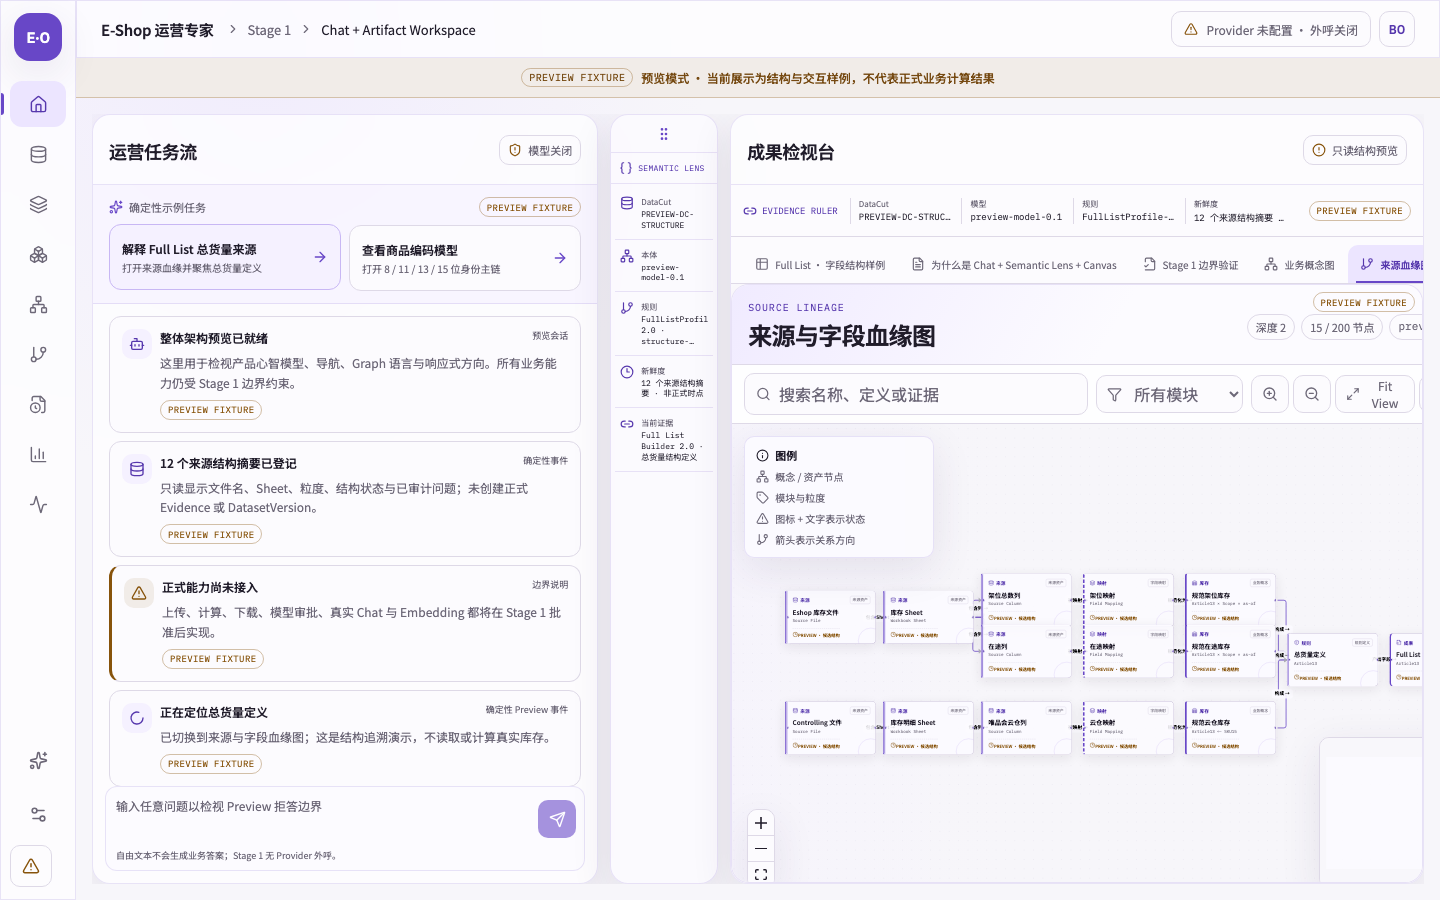
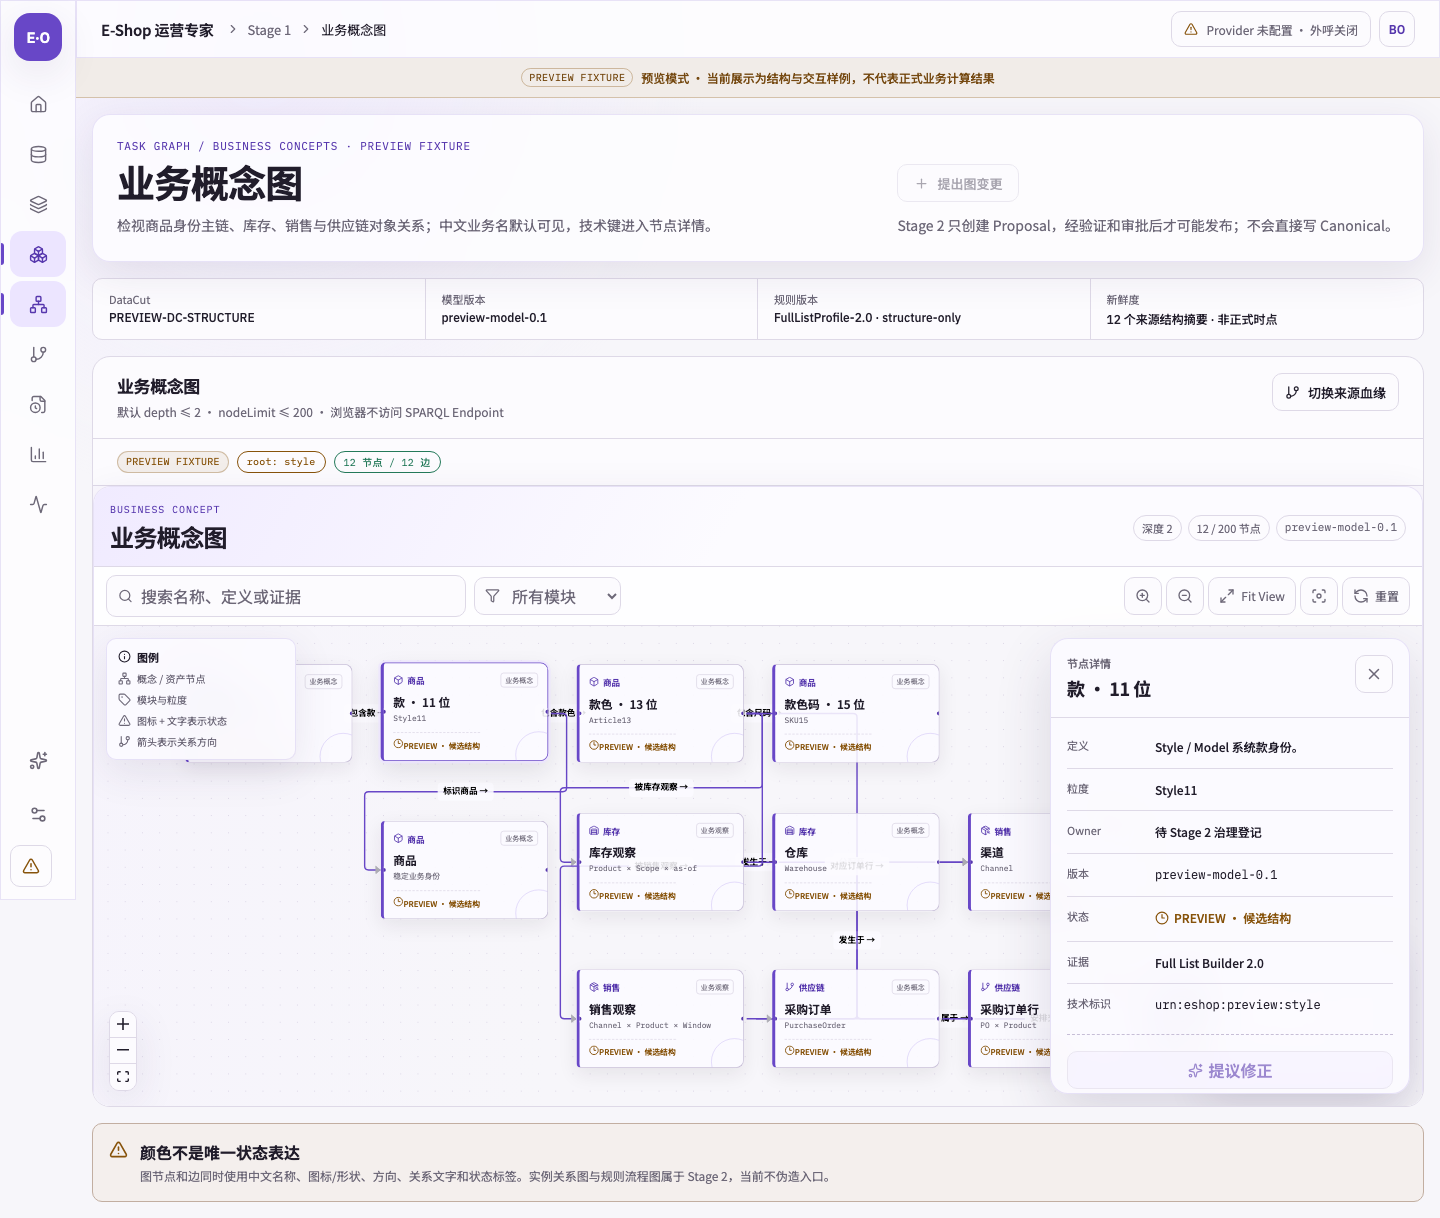
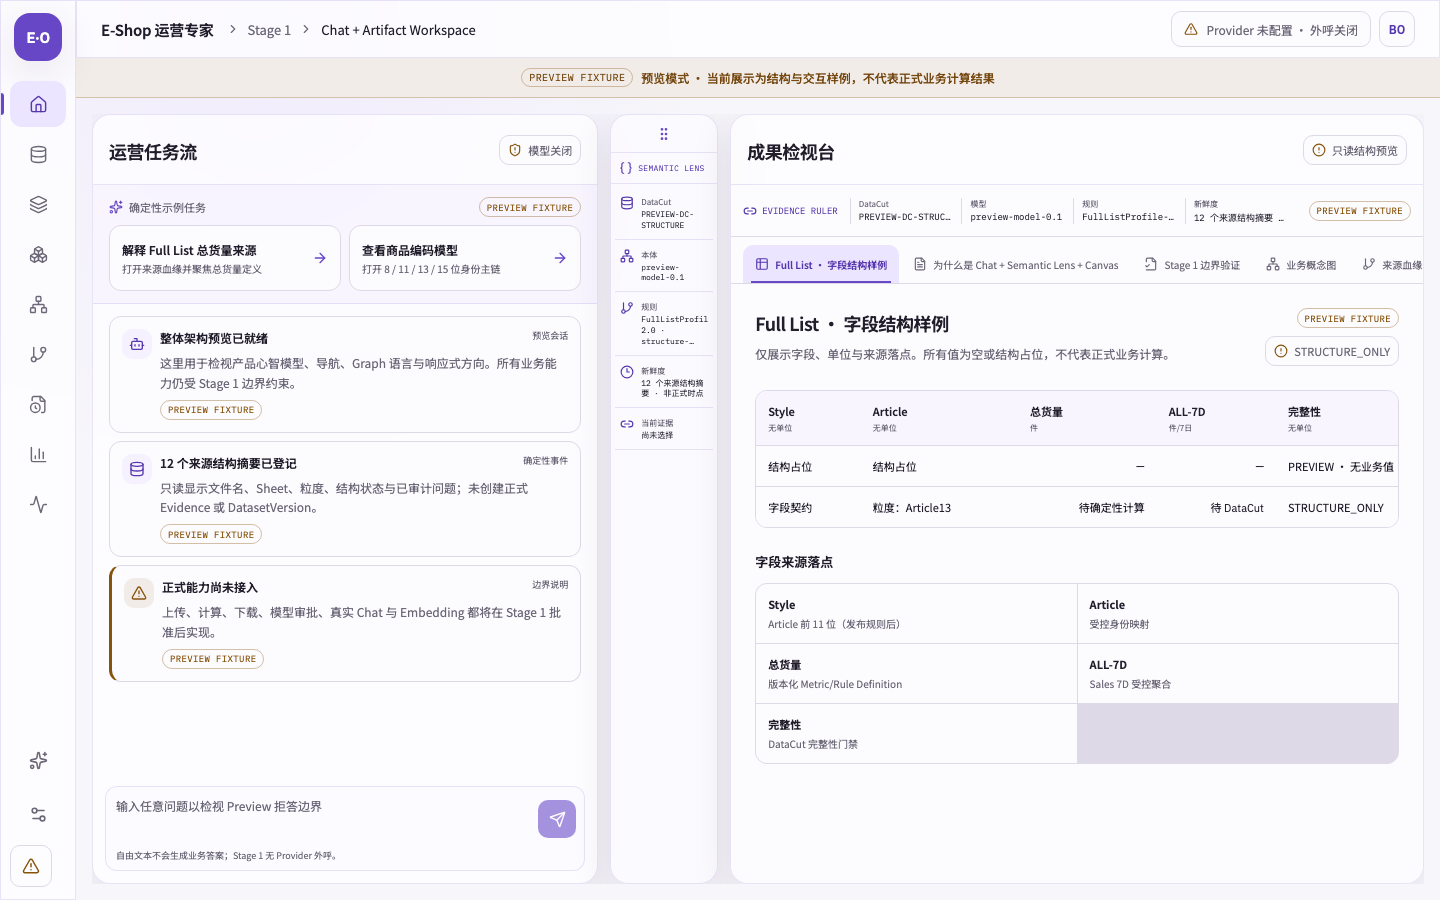
项目已经把多源材料、业务语义、版本冻结、确定性计算、成果交付和来源追溯连成一条可运行的运营决策闭环。运营人员不再只拿到一张没有上下文的结果表,而可以继续检查来源、口径、影响范围和审批记录。
阶段验收材料记录了 8 类核心 E2E 场景、1,348 项 Python 回归通过,以及约 54 MiB、118,694 行 Excel 数据的性能基线;流式解析峰值内存从约 5.1 GiB 降至 274.766 MiB,本地隔离恢复演练记录 RTO 4.792 秒。
这些数字说明的是本地验证版本的工程范围,不等同于目标环境的生产容量、正式 RPO / RTO 或客户经营 ROI。当前对外应表述为“本地验证版本已经完成,正在进入目标环境上线与业务应用阶段”,AI 建议和高风险变更仍然保留人工责任边界。
本案例展示 E-Shop 运营专家的语义化运营工作台、数据治理底座,以及 1,348 项 Python 回归、性能基线与 8 类 E2E 阶段验收成果。